FaceAwareImageKit:让 SwiftUI 图片裁剪始终保留主体
在移动应用里,scaledToFill 几乎是最常用的图片布局方式之一。它简单、稳定,也足够适合大多数场景;但当原图比例与容器比例不一致时,裁剪区域往往由几何中心决定。对于头像、人物卡片和内容流来说,这意味着最重要的主体可能恰好被裁掉。
FaceAwareImageKit 试图解决的,就是这个看似细小、却会直接影响视觉质量的问题:在不改变 SwiftUI 使用习惯的前提下,先在设备端分析图片中的人脸和显著对象,再让 aspect-fill 的裁剪围绕主体完成。
FaceAwareImageKit — GitHub
面向 SwiftUI 的人脸感知图片组件,支持 Vision 分析、异步加载与多级缓存。
先看结果:同样的裁剪比例,主体不再被轻易切掉
普通的 scaledToFill 会把图片的几何中心作为默认焦点;FaceAwareImageKit 则会优先寻找人脸,在没有检测到人脸时回退到显著对象,最后才使用图片中心作为兜底。
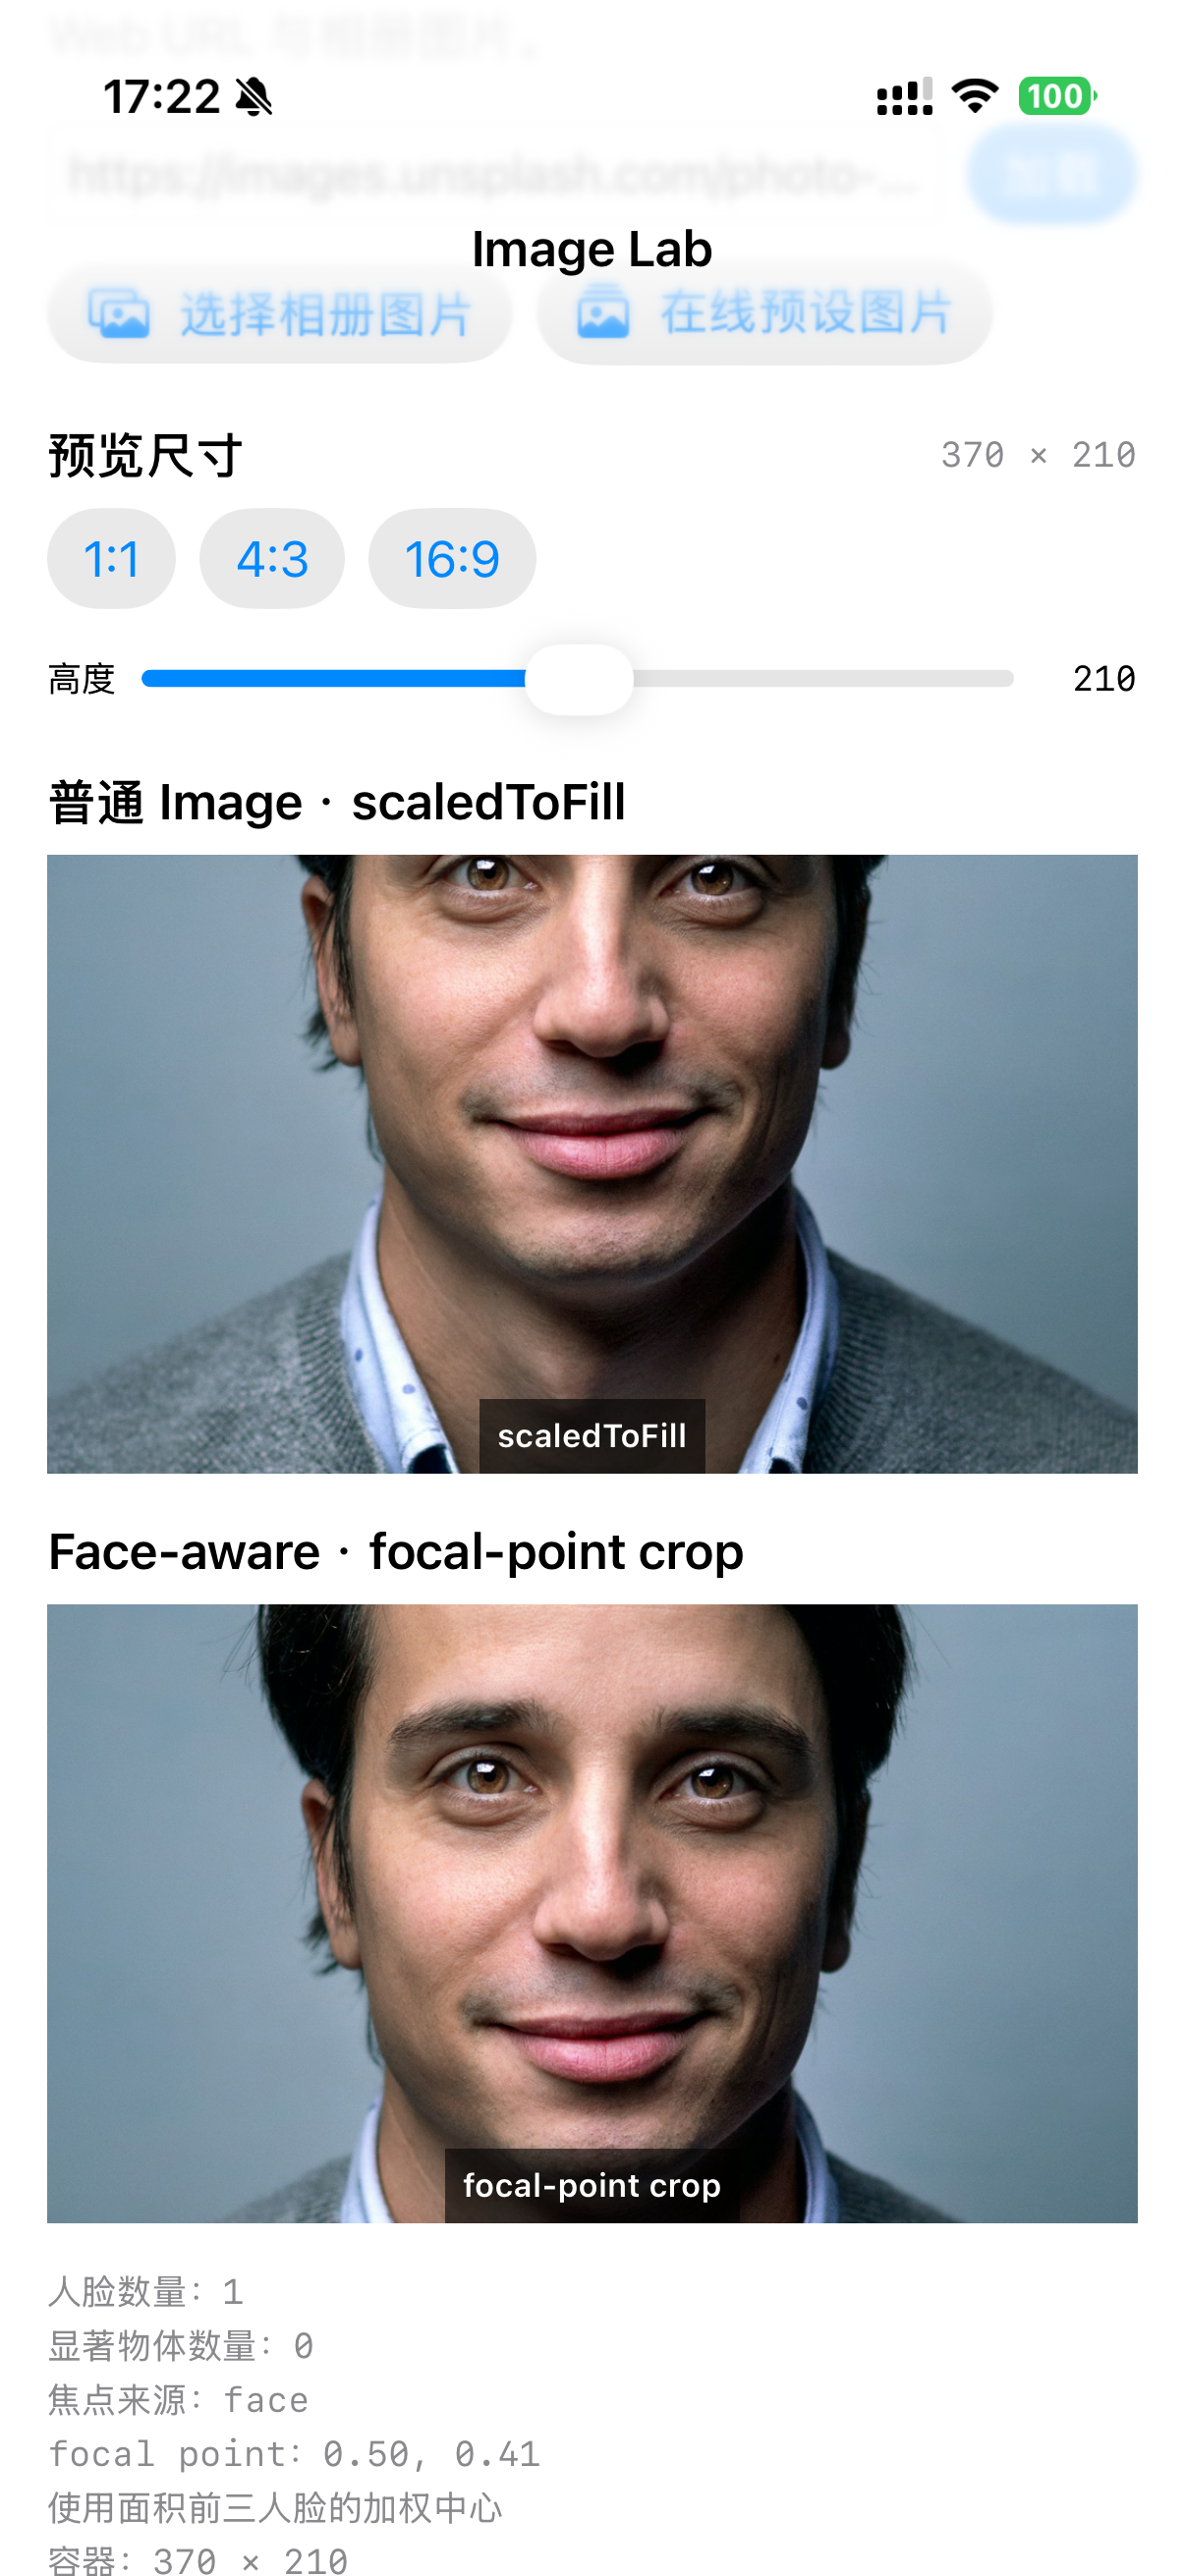
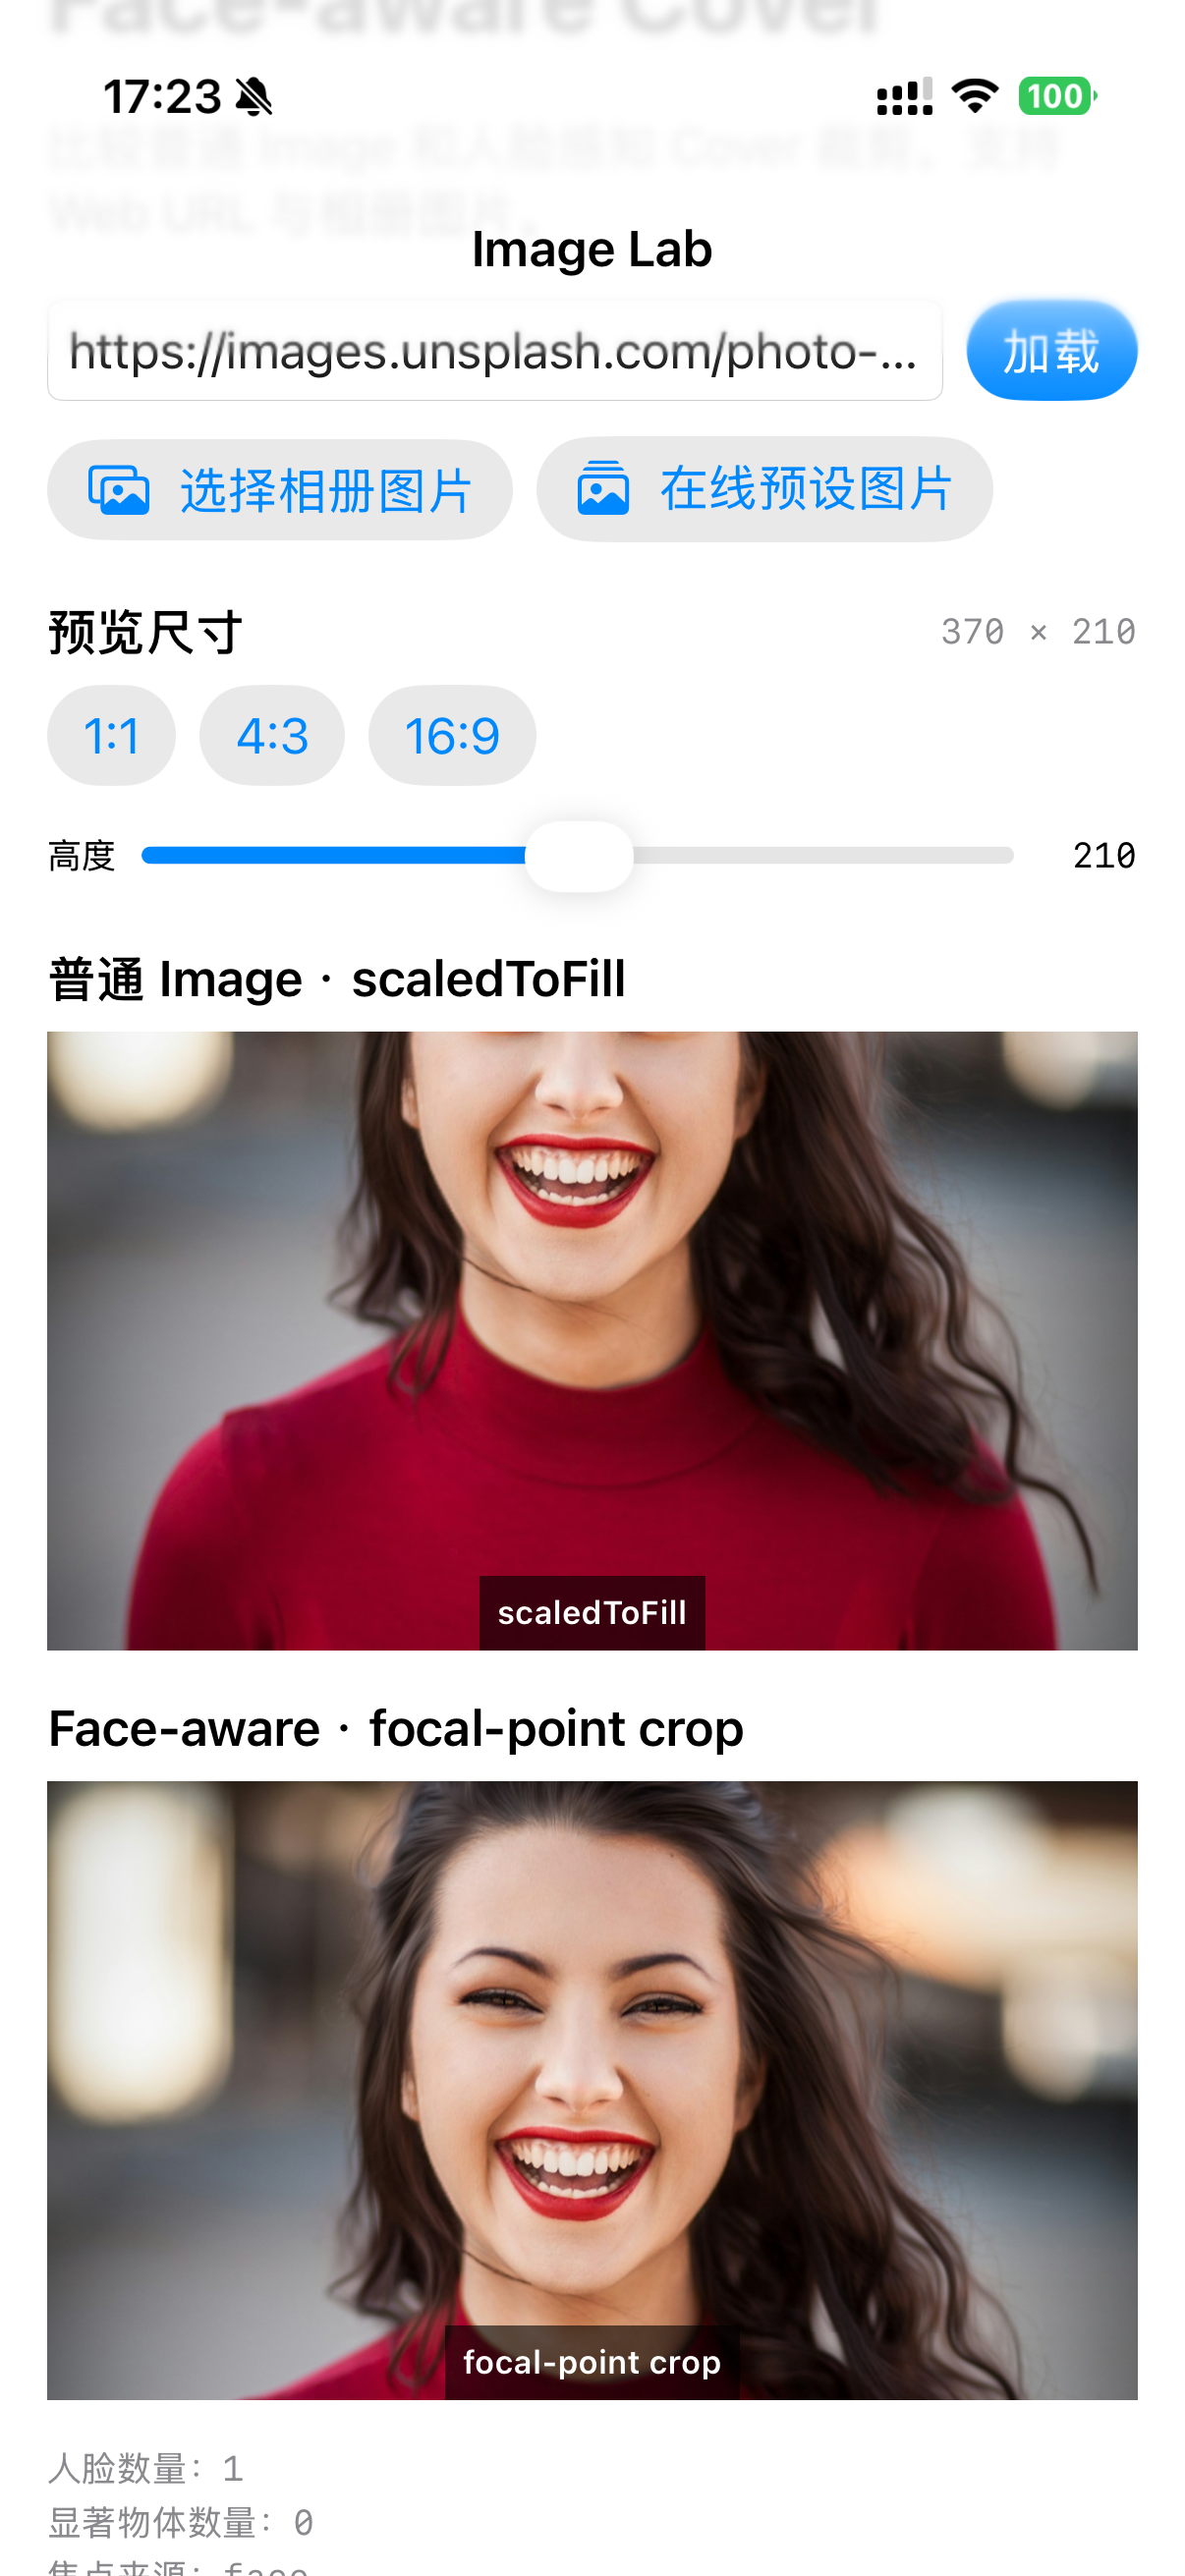
这套策略并不依赖远程服务,也不需要为每张图片预先制作缩略图。分析过程在设备端完成,适合头像、瀑布流、推荐卡片和媒体列表等需要批量加载图片的界面。
它解决了哪些工程问题?
FaceAwareImageKit 并不只是一个“识别人脸”的视图修饰器。它把图片加载、解码、分析、缓存和渲染组织成了一条可以复用的异步管线。
1. 让 SwiftUI 视图保持轻量
对大多数调用方来说,只需要把 URL 交给 FaceAwareAsyncImage,然后像使用普通图片一样设置尺寸和裁剪形状:
import FaceAwareImageKit
import SwiftUI

struct AvatarView: View {
    let url: URL

    var body: some View {
        FaceAwareAsyncImage(url: url)
            .frame(width: 96, height: 96)
            .clipShape(Circle())
    }
}组件会负责加载远程资源、分析焦点并完成 aspect-fill 渲染。调用方不需要自己处理 Vision observation,也不用在每个列表单元格里重复编写裁剪逻辑。
2. 在设备端完成 Vision 分析
库使用 Apple Vision 对图片进行分析,当前的焦点选择顺序是:
- 优先使用检测到的人脸;
- 没有人脸时,尝试使用显著对象;
- 两者都不可用时,回退到图片中心。
这让结果具备可解释的降级路径:图片不包含人物时,仍然可以获得比固定中心裁剪更合理的主体定位;分析失败也不会阻塞常规图片展示。
3. 把重复请求和缓存交给共享客户端
FaceAwareImageClient 是一个 actor,可以在多个视图之间安全共享。它同时管理 HTTP 缓存、解码图片缓存和请求去重,避免同一张图片在列表滚动或多个组件并发出现时被重复下载和解码。
建议在应用启动或功能模块初始化时创建一次自定义客户端,而不是在 body 中重复创建:
let client = FaceAwareImageClient(configuration: .init(
    memoryCacheBytesLimit: 32 * 1024 * 1024,
    preferredImageDimension: 1024,
))

FaceAwareAsyncImage(url: avatarURL, client: client)这种生命周期设计也让缓存容量、分析策略和资源复用边界更加明确。
不只是一种默认样式:也可以接管加载阶段
如果应用需要展示自定义占位图、进度条或错误状态,可以使用带 phase 的内容构建方式:
FaceAwareAsyncImage(url: url) { phase in
    switch phase {
    case .empty:
        ProgressView()
    case .progress(let progress):
        ProgressView(value: progress)
    case .success(let resource, _):
        resource.image
            .resizable()
            .aspectRatio(contentMode: .fill)
    case .failure:
        Image(systemName: "photo")
    }
}对于已经拥有图片数据的场景,客户端也支持直接分析 Data 或 CGImage,再通过 FaceAwareImage 渲染已经处理完成的资源。这给照片编辑、素材预览和本地图片导入等流程留下了足够的扩展空间。
适合哪些场景?
- 头像与成员列表:避免圆形头像裁掉额头、眼睛或面部主体。
- 内容流和推荐卡片:在统一卡片比例下尽量保留人物和关键对象。
- 相册与媒体网格:减少为不同容器比例手动配置 focal point 的工作量。
- 跨设备布局:同一张图片面对手机、平板和桌面窗口的不同尺寸时,仍能使用一致的主体定位策略。
如果界面要求严格的艺术指导、固定构图或手工指定焦点,仍然应该保留显式裁剪能力。FaceAwareImageKit 的价值在于为大量动态图片提供一个合理、稳定的默认结果。
安装与平台要求
通过 Swift Package Manager 添加依赖:
dependencies: [
    .package(
        url: "https://github.com/zsy78191/FaceAwareImageKit.git",
        from: "1.0.0"
    ),
]然后在目标中引入产品:
.product(
    name: "FaceAwareImageKit",
    package: "FaceAwareImageKit"
)项目当前支持:
| 平台 | 最低版本 |
|---|---|
| iOS / iPadOS | 15.0 |
| macOS | 13.0 |
| visionOS | 1.0 |
开发环境要求 Swift 5.9 / Xcode 15 或更高版本。项目不依赖第三方库,核心能力建立在 SwiftUI、Vision、ImageIO、Core Graphics 和 Foundation 之上。
仓库里还提供了什么?
仓库包含一个 FaceAwareImageLab 示例应用,用于直观看到普通 scaledToFill 与人脸感知裁剪之间的差异。除此之外,项目还提供 DocC 文档、单元测试和面向消费者的公共 API 编译测试,方便在接入前了解模块边界与使用方式。
从实现角度看,项目将功能拆分为几个职责清晰的部分:
PublicAPI:对外暴露的 SwiftUI 视图、客户端、配置和资源类型;Analysis:Vision 分析与焦点解析;Loading:异步加载、解码和请求生命周期管理;Cache:HTTP 与解码图片缓存;Rendering:根据焦点计算 aspect-fill 裁剪区域。
这种结构让调用方可以用很少的代码得到完整能力,同时把网络、Vision 和缓存细节留在模块内部维护。
写在最后
图片裁剪通常不会出现在产品需求的第一行,但它会持续影响列表、头像和内容卡片的观感。FaceAwareImageKit 将“主体应该留在画面里”这条经验,整理成了一个可以直接复用的 SwiftUI 组件:上层保持简单,底层则把异步管线、Vision 分析和缓存策略统一起来。
如果你的应用已经大量使用 AsyncImage 或 scaledToFill,这是一个值得在头像、内容流和媒体网格中试用的替代方案。
项目采用 MIT 许可证,欢迎通过 GitHub 查看源码、提交 Issue 或参与改进。